Indice de Diversité Exposée
Mesurer la diversité qu'un fil algorithmique expose réellement — et éprouver ce qu'on croit en savoir.
Ce que ce dépôt contient
Un instrument, et rien d'autre : une mesure de la diversité qu'un fil d'actualité expose réellement à son lecteur, calculable sans accès au code de la plateforme — avec tout ce qu'il faut pour l'établir, l'attaquer, et le mesurer sur des journaux réels.
Douze notebooks exécutables, 256 tests, vingt-sept corrections consignées, et un état des lieux qui ne ressemble ni à ce que le projet annonçait, ni à ce qu'il croyait avoir établi.
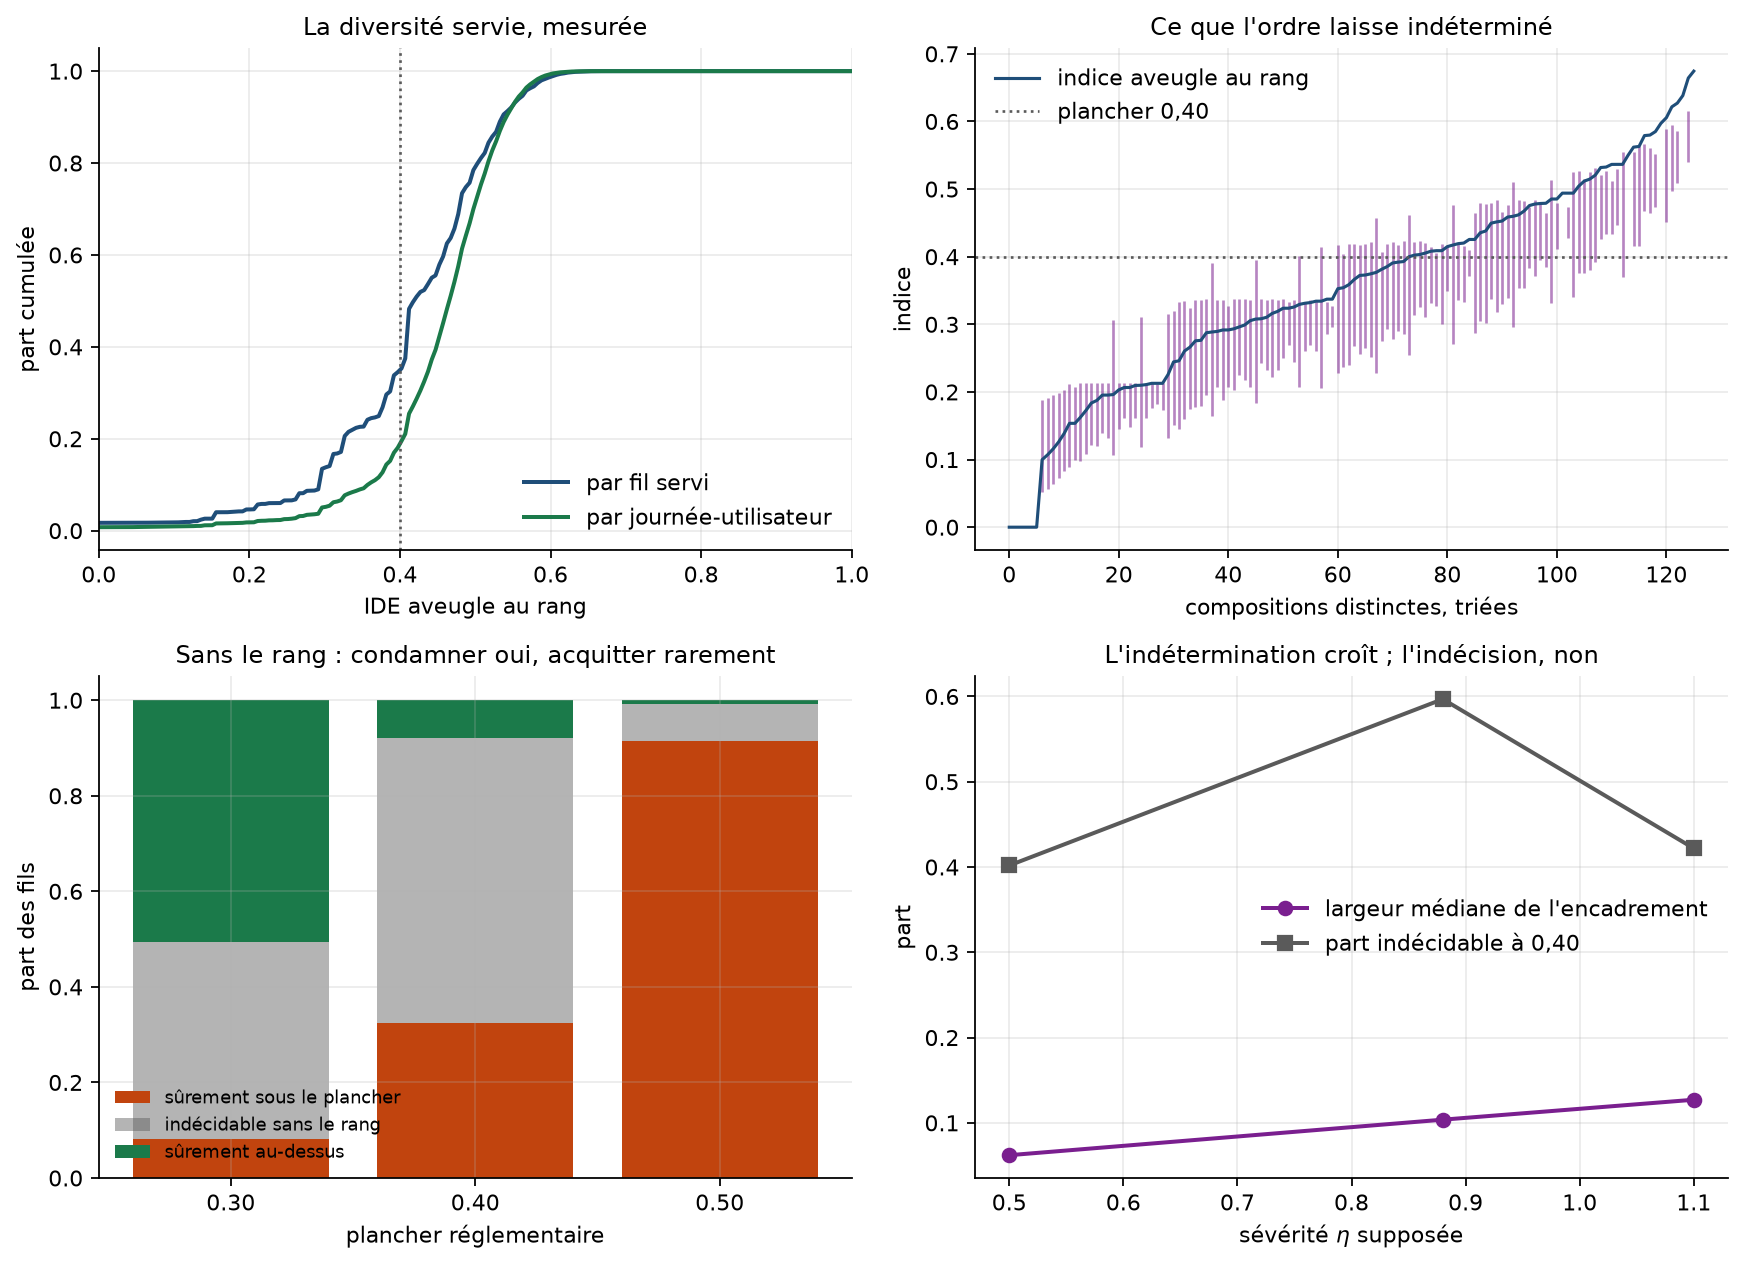
La diversité servie, mesurée sur 232 887 fils du quotidien danois Ekstra Bladet — et ce que l'ordre inconnu laisse indéterminé. Figure régénérée par le notebook 26.
Le verdict, en une page
| Objet | État |
|---|---|
| L'indice tel qu'il était d'abord proposé | intenable : saturable à coût nul, puis contournable par l'enterrement → test adverse · rang adverse |
| La forme retenue | définie et attaquée : entropie des contenus servis sur un catalogue déclaré, pondérée par l'attention de chaque rang → IDE |
| L'exposition, dont dépend cette pondération | mesurée : \(0{,}88 \pm 0{,}05\) et non \(1\) par convention, sans cascade, transportable d'une page à l'autre à 6 % près → exposition mesurée · l'effet de page |
| L'indice aveugle au rang, sur des fils réels | mesuré pour la première fois : 0,50 par journée-utilisateur, 5,1 rubriques effectives sur 26 — mais c'est la forme que le test adverse disqualifie, donc une borne supérieure → l'indice mesuré |
| L'indice exposé, sur ces mêmes fils | encadré, non mesuré — la colonne d'ordre du seul jeu qui l'offre ne contient pas le rang → l'indice mesuré |
| Le catalogue de points de vue | il décide du niveau — 0,50 sur 26 rubriques, 0,92 sur 3 — mais l'ordre entre lecteurs tient jusqu'à six → le catalogue |
| Les instruments de mesure | valides après correction : trois d'entre eux ont dû être restreints, et trois conclusions retirées → contre-expertise |
En une phrase : l'indice tient comme mesure, pas comme norme. Ce qu'il faut pour le calculer se mesure — l'attention, sa forme, sa portabilité. Ce qu'il faudrait pour l'imposer — un niveau, un catalogue, une grandeur agrégée — ne se déduit d'aucune mesure, et le dépôt a cessé de faire semblant du contraire.
Ce qui tient
Cinq objets, et ils sont la seule chose que ce travail demande qu'on lui reprenne. Un test statistique s'applique à d'autres données et répond seul ; il ne demande pas qu'on croie celui qui l'a écrit.
Trois contrôles à passer sur un journal, dans cet ordre. L'échangeabilité — l'ordre enregistré dit-il quelque chose ? — ne détecte rien dans MIND (\(z = +0{,}12\)) et rejette à \(z = -206\) sur Baidu-ULTR ; l'identifiabilité — y a-t-il de quoi estimer ? — nécessaire et non suffisante ; la forme — l'examen dépend-il de ce qui a été cliqué au-dessus ? → MIND · rang servi · test de forme
Une exposition mesurée, et non plus supposée. \(\eta = 0{,}88 \pm 0{,}05\) sur 143 documents, par affichage plutôt que par clic. La cascade est réfutée sur Baidu-ULTR, par deux voies indépendantes. Et la loi en \(R^{-\eta}\) qu'emploie tout le dépôt est le pire des trois ajustements sur la courbe mesurée. → exposition mesurée
Et cette mesure est transportable d'une page à l'autre. C'était la dernière objection, et elle venait de ce dépôt : si la remise d'attention dépendait de la composition de la page, aucune mesure ne pourrait s'écrire sans décrire chaque page servie. À contenu tenu fixe, la dépendance existe mais vaut 6 %, et déplace l'indice de \(0{,}0025\) — quatorze fois moins que la convention \(1/R\) qu'elle devait disqualifier. → l'effet de page
Un encadrement exact quand l'ordre manque. La composition étant connue et l'ordre non, l'indice exposé n'est pas déterminé mais contraint : largeur médiane \(0{,}104\) sur 232 887 fils réels. → l'indice mesuré
Et un premier chiffre réel, là où il n'y avait que des simulations. La diversité servie vaut 0,50 par journée-utilisateur — 5,1 rubriques effectives sur 26 — et le catalogue déplace ce niveau bien plus que le fil lui-même. Avec une réserve qui doit l'accompagner partout : ce chiffre emploie la forme aveugle au rang et fondée sur les étiquettes, celle que le test adverse sature. C'est une borne supérieure, pas la diversité exposée. → l'indice mesuré · le catalogue
Ce qui est tombé
Sur le monde, quatre résultats négatifs :
- aucun jeu public ne permet la mesure annoncée — mais pas pour la raison publiée : EB-NeRD porte les deux colonnes, et c'est sa colonne d'ordre qui ne contient pas l'ordre → l'indice mesuré ;
- l'examen n'est pas une cascade sur Baidu-ULTR, et il ne suit pas une loi de puissance → exposition mesurée ;
- la sévérité de l'attention ne se transporte pas d'une surface à l'autre — 1,1 sur une page de résultats, 0,04 à 0,11 sur un bandeau de trois vignettes → contre-expertise ;
- aucun estimateur contrefactuel ne remplace l'exploration — le doublement robuste fait moins bien que l'estimateur simple → rang servi.
Sur les propositions du dépôt lui-même, cinq de plus :
- un plancher d'indice se sature à coût nul — 1,000 pour une diversité de contenu nulle ;
- le premier correctif prescrivait la polarisation — l'optimum de l'entropie de Rao est bimodal → test adverse ;
- « la proximité à la cible résiste le mieux » était un artefact d'échelle ;
- l'explication du « pli d'écran » est fausse — le rang prédit mieux que les pixels → format et retour ;
- l'effet de format publié était pour les deux tiers une composition — 18 % à rang fixé, 6 % à contenu fixé → l'effet de page.
Ce qui n'est pas tranché
- L'indice exposé n'a jamais été mesuré sur un fil réel — seulement encadré, à 0,104 près. La lacune est de donnée, non de méthode : il y faudrait un rang vérifiable.
- Une rubrique n'est pas un point de vue. Le seul chiffre réel dont le dépôt dispose porte sur la diversité thématique exposée. Deux axes d'étiquetage du même corpus ne concordent qu'à \(\rho = 0{,}16\). → le catalogue
- Rien n'a été validé de l'extérieur. Les 256 tests vérifient que le code fait ce qui est annoncé, non que ce qui est annoncé soit vrai, et aucun relecteur n'est passé. C'est le seul verrou que ce dépôt ne peut pas lever seul. → appel à relecture
D'où cela vient, et ce qui a été retiré
Le projet est parti d'une analogie entre décohérence quantique et effondrement du consensus, en a tiré un formalisme emprunté à la physique statistique, un algorithme de recommandation et un cadre de régulation. Les trois ont été retirés.
L'analogie parce que l'audit a réfuté chacune de ses affirmations propres. Le formalisme parce que sa seule prédiction testable — l'effet de la charge émotionnelle — a été mesurée quatre fois sans effet. L'appareil de régulation parce que ses propres mesures l'ont vidé de sa substance : un plancher dont le niveau dépend du catalogue, qu'un contenu servi sur 177 suffit à satisfaire, et dont la grandeur agrégée invite à traiter la marge plutôt que les lecteurs les plus enfermés.
Ce qui reste est ce qui a survécu à ses propres contrôles. L'audit garde le registre entier des vingt-sept corrections, y compris celles qui portent sur les moitiés retirées : c'est le registre de ce que ce travail a eu faux, et c'est la partie qu'on ne supprime pas.
Reproduire
Tout passe par Docker, rien n'est installé localement.
docker compose run --rm test          # 256 tests
docker compose run --rm notebooks     # exécute les notebooks, régénère les figures
docker compose up site                # http://localhost:8000
Les douze notebooks sont exécutables et produisent l'intégralité des figures. Les journaux bruts ne sont pas versionnés — licences propres, plusieurs gigaoctets — mais leurs condensés le sont, et tout se recalcule à l'identique depuis eux.
Les numéros des notebooks ne sont pas continus : les manques sont ceux des chapitres retirés, et ils sont laissés tels quels plutôt que renumérotés, pour que l'audit continue de désigner ce dont il parle.