14 — Le rang et le contrefactuel : deux angles morts de l'évaluation¶
Le test adverse a corrigé deux fois la définition de l'index : mesurer les contenus et non les étiquettes, puis ne pas mesurer par l'entropie de Rao, qui prescrivait la polarisation. Deux hypothèses restaient, implicites l'une et l'autre, et fausses l'une et l'autre.
Que la position d'un contenu dans le fil ne compte pas. Elle compte : un lecteur consulte le premier élément bien plus souvent que le huitième, et une plateforme tenue à un plancher de diversité peut s'y conformer en plaçant les contenus divergents en bas. C'est un quatrième adversaire, et il n'avait pas été éprouvé.
Qu'un fil enregistré puisse servir à évaluer un filtre qui ne l'a pas produit. Il ne le peut pas sans correction : les clics enregistrés portent l'exposition que la plateforme avait accordée, et un filtre de diversité fait précisément remonter ce qu'elle avait enterré.
Ce que ce notebook établit :
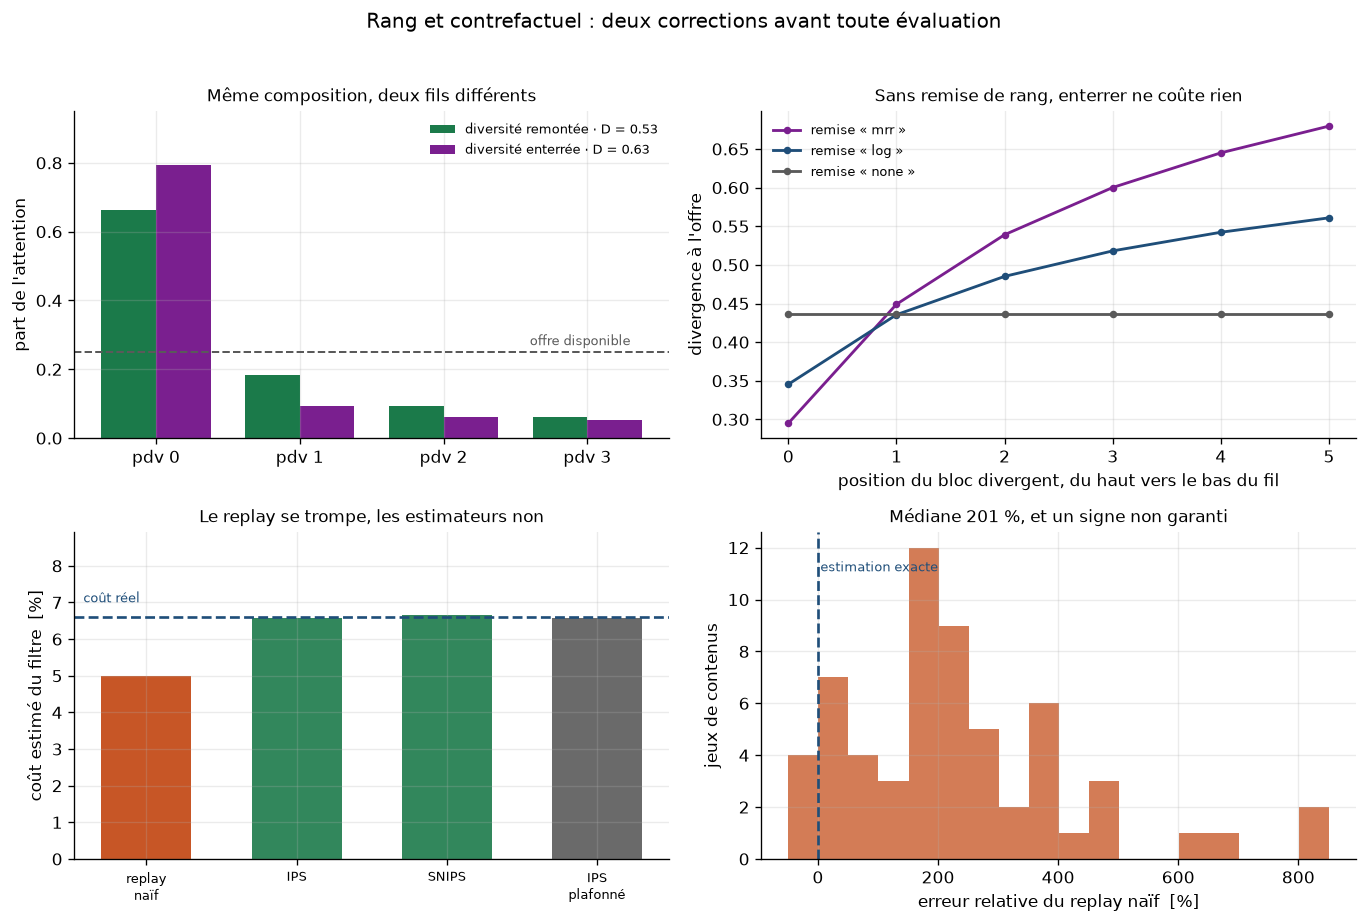
- l'enterrement fonctionne — à composition rigoureusement identique, une permutation seule fait passer la divergence de 0,525 à 0,630 et rapporte 10 % d'engagement, sans qu'aucune mesure ponctuelle n'y voie de différence ;
- la remise de rang de RADio ferme cette échappatoire, et remplace du même geste une valeur ponctuelle par une divergence à une référence déclarée ;
- l'évaluation naïve d'un réordonnancement sur données enregistrées se trompe de 201 % en médiane, jusqu'à 851 % — et son sens n'est pas garanti ;
- les estimateurs contrefactuels retrouvent la valeur vraie à moins d'un point.
1. Le quatrième adversaire : se conformer en enterrant¶
La remise de rang de RADio pondère chaque position par l'attention qu'elle reçoit :
La conséquence est immédiate : deux fils composés des mêmes contenus mais rangés différemment n'ont plus la même mesure.
import numpy as np
import matplotlib.pyplot as plt

from ide.gaming import position_entropy
from ide.offpolicy import (
    clipped_ips,
    effective_sample_size,
    ips,
    naive,
    naive_replay,
    rank_propensities,
    simulate_logged_feedback,
    snips,
    value_under_policy,
)
from ide.plotting import PALETTE, save_figure, use_project_style
from ide.radio import (
    calibration,
    fragmentation,
    rank_aware_distribution,
    rank_weights,
    representation,
)

use_project_style()

VIEWPOINTS = 4
SUPPLY = np.arange(VIEWPOINTS)          # l'offre disponible, équilibrée
CATALOGUE = np.arange(VIEWPOINTS, dtype=float)

# Deux fils de huit positions, de composition RIGOUREUSEMENT identique : cinq contenus du
# point de vue que le lecteur préfère, et un de chacun des trois autres. Seul l'ordre diffère.
diversified = np.array([0, 1, 0, 2, 0, 3, 0, 0])   # la diversité est remontée
favouring = np.array([0, 0, 0, 1, 0, 2, 3, 0])     # la diversité est enterrée

for name, feed in (("diversité remontée", diversified), ("diversité enterrée", favouring)):
    composition = np.bincount(feed, minlength=VIEWPOINTS) / feed.size
    print(f"{name:22s} composition {np.bincount(feed, minlength=VIEWPOINTS)}"
          f"   entropie de position {position_entropy(composition, CATALOGUE, CATALOGUE):.3f}")

print("\nMême composition, même entropie de position : la mesure ponctuelle est aveugle")
print("à l'ordre, donc à l'enterrement.")
diversité remontée     composition [5 1 1 1]   entropie de position 0.774
diversité enterrée     composition [5 1 1 1]   entropie de position 0.774

Même composition, même entropie de position : la mesure ponctuelle est aveugle
à l'ordre, donc à l'enterrement.
print("remise de rang réciproque :", np.round(rank_weights(8, "mrr"), 3), "\n")

print(f"{'fil':34s} {'distribution consciente du rang':>34s} {'divergence':>12s}")
print("-" * 84)
for name, feed in (("diversité remontée", diversified), ("diversité enterrée", favouring)):
    distribution = rank_aware_distribution(feed, VIEWPOINTS, "mrr")
    print(f"{name:34s} {str(np.round(distribution, 3)):>34s}"
          f" {representation(feed, SUPPLY, VIEWPOINTS):12.3f}")

print(f"\ncomposition : {np.bincount(diversified, minlength=VIEWPOINTS)}"
      f" et {np.bincount(favouring, minlength=VIEWPOINTS)} — identiques.")
print("Seule la permutation change, et la divergence en rend compte.")
remise de rang réciproque : [1.    0.5   0.333 0.25  0.2   0.167 0.143 0.125]

fil                                   distribution consciente du rang   divergence
------------------------------------------------------------------------------------
diversité remontée                          [0.663 0.184 0.092 0.061]        0.525
diversité enterrée                          [0.794 0.092 0.061 0.053]        0.630

composition : [5 1 1 1] et [5 1 1 1] — identiques.
Seule la permutation change, et la divergence en rend compte.
Pourquoi enterrer est rentable¶
L'enterrement ne serait qu'une curiosité si le lecteur consultait tout le fil. Ce n'est pas le cas, et le modèle qui le dit — le biais de position \(e(R) = R^{-\eta}\) — est le même que celui dont les estimateurs contrefactuels de la seconde partie ont besoin. Ce n'est pas une coïncidence : c'est la même ignorance, vue depuis la mesure puis depuis l'évaluation.
SEVERITY = 1.0
# Pertinence de chaque point de vue pour un lecteur qui préfère le point de vue 0.
relevance_by_viewpoint = np.array([0.90, 0.45, 0.25, 0.15])

def engagement_of(feed, severity=SEVERITY):
    exposure = rank_propensities(np.arange(1, feed.size + 1), severity, normalise=False)
    return float(np.sum(exposure * relevance_by_viewpoint[feed]))

print(f"{'fil':24s} {'engagement':>12s} {'divergence':>12s}")
print("-" * 50)
for name, feed in (("diversité remontée", diversified), ("diversité enterrée", favouring)):
    print(f"{name:24s} {engagement_of(feed):12.3f}"
          f" {representation(feed, SUPPLY, VIEWPOINTS):12.3f}")

gain = engagement_of(favouring) / engagement_of(diversified) - 1
print(f"\nEnterrer rapporte {100 * gain:.0f} % d'engagement, à composition inchangée.")
print("Une norme aveugle au rang offre donc ce gain gratuitement.")
fil                        engagement   divergence
--------------------------------------------------
diversité remontée              1.934        0.525
diversité enterrée              2.118        0.630

Enterrer rapporte 10 % d'engagement, à composition inchangée.
Une norme aveugle au rang offre donc ce gain gratuitement.
2. Ce que RADio déplace : de la valeur ponctuelle à la référence déclarée¶
Le second apport de RADio importe autant que le premier. Les cinq mesures sont la même divergence appliquée à des paires de distributions différentes ; ce qui les distingue est le choix de la référence, et c'est lui qui porte la valeur normative.
| Mesure | Distribution servie | Référence |
|---|---|---|
| calibration | catégories du fil | historique de lecture du lecteur |
| fragmentation | fil d'un lecteur | fil d'un autre lecteur |
| activation | intensité affective du fil | intensité dans l'offre |
| représentation | points de vue du fil | points de vue dans l'offre |
| voix alternatives | voix minoritaires du fil | voix minoritaires dans l'offre |
Cela résout le défaut de principe relevé au notebook 13 : l'entropie suppose que l'uniforme est l'idéal, l'entropie de Rao suppose que l'écartement l'est, et aucune ne le dit.
history = np.array([0, 0, 0, 0, 1, 0, 0, 1])     # un lecteur très polarisé
conforming = np.array([0, 0, 0, 1, 0, 0, 1, 0])  # un fil qui l'épouse
opening = np.array([0, 1, 2, 0, 3, 1, 2, 3])     # un fil qui l'ouvre

print(f"{'fil servi':22s} {'calibration':>13s}   lecture")
print("-" * 72)
for name, feed, reading in (
    ("conforme à l'historique", conforming, "objectif d'un recommandeur libéral"),
    ("ouvrant sur d'autres", opening, "objectif d'un recommandeur délibératif"),
):
    print(f"{name:22s} {calibration(feed, history, VIEWPOINTS):13.3f}   {reading}")

print("\nLa même mesure, deux verdicts opposés selon la valeur qu'on poursuit.")
print("La divergence mesure ; elle ne tranche pas — et c'est ce qu'elle a de mieux à offrir.")
fil servi                calibration   lecture
------------------------------------------------------------------------
conforme à l'historique         0.013   objectif d'un recommandeur libéral
ouvrant sur d'autres           0.173   objectif d'un recommandeur délibératif

La même mesure, deux verdicts opposés selon la valeur qu'on poursuit.
La divergence mesure ; elle ne tranche pas — et c'est ce qu'elle a de mieux à offrir.
alice = np.array([0, 0, 1, 0, 1, 0, 0, 1])
bob_similar = np.array([0, 1, 0, 0, 1, 1, 0, 0])
bob_apart = np.array([3, 3, 2, 3, 2, 2, 3, 3])

print(f"{'paire de lecteurs':28s} {'fragmentation':>14s}")
print("-" * 46)
print(f"{'Alice et un Bob voisin':28s} {fragmentation(alice, bob_similar, VIEWPOINTS):14.3f}")
print(f"{'Alice et un Bob distant':28s} {fragmentation(alice, bob_apart, VIEWPOINTS):14.3f}")
print("\nSeule des cinq à ne pas comparer un fil à une référence globale : elle demande")
print("si deux lecteurs partagent encore un espace commun — ce que le reste du dépôt")
print("appelle un régime figé.")
paire de lecteurs             fragmentation
----------------------------------------------
Alice et un Bob voisin                0.005
Alice et un Bob distant               1.000

Seule des cinq à ne pas comparer un fil à une référence globale : elle demande
si deux lecteurs partagent encore un espace commun — ce que le reste du dépôt
appelle un régime figé.
3. Le piège de l'évaluation hors ligne¶
La feuille de route §3.1 annonce d'évaluer l'ADE sur un jeu de données public : réordonner des fils enregistrés, mesurer le gain de diversité et la perte de pertinence. Prise au pied de la lettre, cette mesure est fausse.
Les clics enregistrés n'ont pas été produits par le filtre qu'on évalue. Un clic dépend de la pertinence du contenu et de l'exposition qu'on lui a donnée : un article que la plateforme avait enterré a peu de clics — non parce qu'il n'intéressait personne, mais parce que personne ne l'a vu.
Ici, la valeur vraie est connue : c'est une simulation. Sur données réelles, c'est exactement la quantité qu'on cherche et qu'on n'a pas.
ITEMS = 20
IMPRESSIONS = 400_000

def experiment(seed=11, severity=1.0, diversity_weight=0.6, items=ITEMS,
               impressions=IMPRESSIONS):
    rng = np.random.default_rng(seed)
    relevance = rng.uniform(0.05, 0.95, items)
    diversity = rng.uniform(0.0, 1.0, items)

    # La plateforme classe par pertinence ; le filtre de diversité contrarie ce classement.
    logged_ranks = np.argsort(np.argsort(-relevance)) + 1
    score = (1 - diversity_weight) * relevance + diversity_weight * diversity
    target_ranks = np.argsort(np.argsort(-score)) + 1

    logged = rank_propensities(logged_ranks, severity)
    target = rank_propensities(target_ranks, severity)
    examined, clicks = simulate_logged_feedback(relevance, logged, impressions, rng)
    rates = np.bincount(examined, weights=clicks, minlength=items) / impressions

    return {
        "relevance": relevance, "logged": logged, "target": target,
        "examined": examined, "clicks": clicks, "rates": rates,
    }

run = experiment()
truth = value_under_policy(run["relevance"], run["target"])
logged_value = value_under_policy(run["relevance"], run["logged"])
weights = (run["target"][run["examined"]], run["logged"][run["examined"]])

print(f"valeur vraie de la politique évaluée        : {truth:.4f}")
print(f"valeur vraie de la politique d'enregistrement : {logged_value:.4f}\n")
print(f"{'estimateur':22s} {'estimation':>11s} {'écart':>9s}")
print("-" * 46)
for name, estimate in (
    ("moyenne naïve", naive(run["clicks"])),
    ("IPS", ips(run["clicks"], *weights)),
    ("SNIPS", snips(run["clicks"], *weights)),
    ("IPS plafonné à 5", clipped_ips(run["clicks"], *weights, cap=5.0)),
):
    print(f"{name:22s} {estimate:11.4f} {100 * (estimate - truth) / truth:8.1f} %")

print("\nLa moyenne naïve n'est pas imprécise : elle répond à une autre question.")
print("Elle estime la valeur de la politique d'enregistrement, non celle qu'on évalue.")
valeur vraie de la politique évaluée        : 0.6488
valeur vraie de la politique d'enregistrement : 0.6947

estimateur              estimation     écart
----------------------------------------------
moyenne naïve               0.6942      7.0 %
IPS                         0.6486     -0.0 %
SNIPS                       0.6481     -0.1 %
IPS plafonné à 5            0.6486     -0.0 %

La moyenne naïve n'est pas imprécise : elle répond à une autre question.
Elle estime la valeur de la politique d'enregistrement, non celle qu'on évalue.
L'estimateur qu'on emploie réellement, et son erreur¶
La moyenne naïve ne dépend pas du filtre évalué : personne ne s'en sert pour comparer deux filtres. L'estimateur réellement employé est le replay — on réordonne les candidats, puis on somme les clics observés pondérés par l'exposition que le nouveau classement leur donnerait.
Son biais est structurel : le taux de clic observé porte déjà l'exposition que la plateforme avait accordée, si bien que l'estimateur l'applique deux fois.
def costs(run):
    # Coût relatif du filtre de diversité : vrai, puis estimé de deux façons.
    truth = 1 - value_under_policy(run["relevance"], run["target"]) / value_under_policy(
        run["relevance"], run["logged"]
    )
    replay = 1 - naive_replay(run["rates"], run["target"]) / naive_replay(
        run["rates"], run["logged"]
    )
    corrected = 1 - snips(
        run["clicks"], run["target"][run["examined"]], run["logged"][run["examined"]]
    ) / naive(run["clicks"])
    return truth, replay, corrected

true_cost, replay_cost, corrected_cost = costs(run)
print(f"coût réel du filtre de diversité   : {100 * true_cost:5.1f} %")
print(f"  estimé par replay naïf           : {100 * replay_cost:5.1f} %")
print(f"  estimé par SNIPS                 : {100 * corrected_cost:5.1f} %")
coût réel du filtre de diversité   :   6.6 %
  estimé par replay naïf           :   5.0 %
  estimé par SNIPS                 :   6.6 %
errors, overestimates = [], 0
draws = 0
for seed in range(60):
    sample = experiment(seed=seed, items=12, impressions=60_000)
    drawn_true, drawn_replay, _ = costs(sample)
    if drawn_true <= 0:
        continue
    draws += 1
    errors.append((drawn_replay - drawn_true) / drawn_true)
    overestimates += drawn_replay > drawn_true

errors = np.array(errors)
print(f"sur {draws} jeux de contenus, à configuration identique :\n")
print(f"  erreur relative médiane du replay : {100 * np.median(np.abs(errors)):.0f} %")
print(f"  pire cas                          : {100 * errors.max():+.0f} %")
print(f"  surestime le coût                 : {overestimates}/{draws}")
print(f"  le sous-estime                    : {draws - overestimates}/{draws}")
print("\nOn aimerait pouvoir dire que le biais est conservateur — qu'il surestime toujours")
print("le coût, et qu'un résultat favorable resterait donc défendable. Il ne l'est pas.")
sur 60 jeux de contenus, à configuration identique :

  erreur relative médiane du replay : 201 %
  pire cas                          : +851 %
  surestime le coût                 : 56/60
  le sous-estime                    : 4/60

On aimerait pouvoir dire que le biais est conservateur — qu'il surestime toujours
le coût, et qu'un résultat favorable resterait donc défendable. Il ne l'est pas.
Lecture¶
L'erreur médiane est de 201 %. Ce n'est pas une imprécision, c'est un ordre de grandeur : la mesure naïve donne typiquement le triple du coût réel.
Et son sens n'est pas garanti. Elle surestime le coût dans cinquante-six cas sur soixante, ce qui inviterait à la tenir pour prudente — mais elle le sous-estime dans les quatre autres, à configuration pourtant identique. Le sens dépend du jeu de contenus, donc de données qu'on ne choisit pas.
Un chiffre naïf n'est pas une borne supérieure. C'est un chiffre faux d'un montant considérable et d'un sens que rien ne garantit.
4. Ce qu'il faut publier à côté du chiffre¶
Un estimateur sans biais ne suffit pas : il faut dire ce sur quoi il repose, et combien d'observations le portent réellement.
print(f"{'écart des politiques':26s} {'taille effective':>18s} {'sur':>8s}")
print("-" * 56)
for weight in (0.0, 0.3, 0.6, 0.9):
    sample = experiment(diversity_weight=weight, impressions=60_000)
    size = effective_sample_size(
        sample["target"][sample["examined"]], sample["logged"][sample["examined"]]
    )
    print(f"{f'poids de diversité {weight:.1f}':26s} {size:18.0f} {sample['clicks'].size:8d}")

print("\nPlus la politique évaluée s'éloigne de celle qui a produit les données, moins il")
print("reste d'observations pour l'estimer. Une estimation sans biais adossée à quelques")
print("centaines d'observations effectives n'est pas une mesure, c'est un chiffre.")
écart des politiques         taille effective      sur
--------------------------------------------------------
poids de diversité 0.0                  60000    60000
poids de diversité 0.3                  55547    60000
poids de diversité 0.6                  47660    60000
poids de diversité 0.9                  10026    60000

Plus la politique évaluée s'éloigne de celle qui a produit les données, moins il
reste d'observations pour l'estimer. Une estimation sans biais adossée à quelques
centaines d'observations effectives n'est pas une mesure, c'est un chiffre.
print(f"{'plafond':>9s} {'estimation':>12s} {'écart à la vérité':>19s}")
print("-" * 44)
truth_value = value_under_policy(run["relevance"], run["target"])
for cap in (1.2, 2.0, 5.0, 20.0, 1e6):
    estimate = clipped_ips(run["clicks"], *weights, cap=cap)
    label = "aucun" if cap > 1e5 else f"{cap:.1f}"
    print(f"{label:>9s} {estimate:12.4f} {100 * (estimate - truth_value) / truth_value:18.1f} %")

print("\nLe plafond doit être publié avec le résultat : son choix suffit à déplacer")
print("l'estimation, et sans lui le chiffre n'est pas reproductible.")
  plafond   estimation   écart à la vérité
--------------------------------------------
      1.2       0.6064               -6.5 %
      2.0       0.6412               -1.2 %
      5.0       0.6486               -0.0 %
     20.0       0.6486               -0.0 %
    aucun       0.6486               -0.0 %

Le plafond doit être publié avec le résultat : son choix suffit à déplacer
l'estimation, et sans lui le chiffre n'est pas reproductible.
figure, axes = plt.subplots(2, 2, figsize=(11.5, 7.8))
burial, references, estimators, sample_size = axes.ravel()

# (a) L'enterrement : même composition, deux distributions conscientes du rang.
width = 0.38
labels = [f"pdv {i}" for i in range(VIEWPOINTS)]
positions = np.arange(VIEWPOINTS)
up = rank_aware_distribution(diversified, VIEWPOINTS, "mrr")
down = rank_aware_distribution(favouring, VIEWPOINTS, "mrr")
burial.bar(positions - width / 2, up, width, color=PALETTE["remedy"],
           label=f"diversité remontée · D = {representation(diversified, SUPPLY, VIEWPOINTS):.2f}")
burial.bar(positions + width / 2, down, width, color=PALETTE["field"],
           label=f"diversité enterrée · D = {representation(favouring, SUPPLY, VIEWPOINTS):.2f}")
burial.axhline(1 / VIEWPOINTS, color=PALETTE["neutral"], linestyle="--", linewidth=1.2)
burial.text(VIEWPOINTS - 1.4, 1 / VIEWPOINTS + 0.02, "offre disponible", fontsize=7.5,
            color=PALETTE["neutral"])
burial.set_xticks(positions)
burial.set_xticklabels(labels)
burial.set_ylabel("part de l'attention")
burial.set_title("Même composition, deux fils différents", fontsize=10)
burial.set_ylim(0, 0.95)
burial.legend(fontsize=7.5, loc="upper right")

# (b) La remise de rang, et ce qu'elle change selon sa forme.
# La composition reste rigoureusement fixe : seul l'emplacement du bloc divergent glisse.
offsets = np.arange(0, 6)
for discount, colour in (("mrr", PALETTE["field"]), ("log", PALETTE["order"]),
                         ("none", PALETTE["neutral"])):
    curve = []
    for offset in offsets:
        feed = np.zeros(8, dtype=int)
        feed[offset:offset + 3] = np.array([1, 2, 3])
        curve.append(representation(feed, SUPPLY, VIEWPOINTS, discount=discount))
    references.plot(offsets, curve, marker="o", markersize=3.5, linewidth=1.7, color=colour,
                    label=f"remise « {discount} »")
references.set_xlabel("position du bloc divergent, du haut vers le bas du fil")
references.set_ylabel("divergence à l'offre")
references.set_title("Sans remise de rang, enterrer ne coûte rien", fontsize=10)
references.legend(fontsize=8)

# (c) Les estimateurs, contre la valeur vraie.
names = ["replay\nnaïf", "IPS", "SNIPS", "IPS\nplafonné"]
values = [replay_cost, 1 - ips(run["clicks"], *weights) / naive(run["clicks"]),
          corrected_cost, 1 - clipped_ips(run["clicks"], *weights, cap=5.0) / naive(run["clicks"])]
colours = [PALETTE["disorder"]] + [PALETTE["remedy"]] * 2 + [PALETTE["neutral"]]
estimators.bar(np.arange(len(names)), [100 * v for v in values], 0.6, color=colours, alpha=0.9)
estimators.axhline(100 * true_cost, color=PALETTE["order"], linestyle="--", linewidth=1.6)
estimators.set_ylim(0, 100 * true_cost * 1.35)
estimators.text(-0.42, 100 * true_cost * 1.06, "coût réel", fontsize=8,
                color=PALETTE["order"])
estimators.set_xticks(np.arange(len(names)))
estimators.set_xticklabels(names, fontsize=8)
estimators.set_ylabel("coût estimé du filtre  [%]")
estimators.set_title("Le replay se trompe, les estimateurs non", fontsize=10)

# (d) La distribution des erreurs du replay, sur soixante jeux de contenus.
sample_size.hist(100 * errors, bins=18, color=PALETTE["disorder"], alpha=0.7)
sample_size.axvline(0, color=PALETTE["order"], linestyle="--", linewidth=1.6)
sample_size.text(4, sample_size.get_ylim()[1] * 0.88, "estimation exacte", fontsize=8,
                 color=PALETTE["order"])
sample_size.set_xlabel("erreur relative du replay naïf  [%]")
sample_size.set_ylabel("jeux de contenus")
sample_size.set_title(f"Médiane {100 * np.median(np.abs(errors)):.0f} %, et un signe non garanti",
                      fontsize=10)

figure.suptitle("Rang et contrefactuel : deux corrections avant toute évaluation", fontsize=12)
figure.tight_layout(rect=(0, 0, 1, 0.96))
save_figure(figure, "fig14_rang_et_contrefactuel")
plt.show()
5. Ce que le notebook établit¶
Le quatrième adversaire fonctionne, et la remise de rang le ferme. À composition rigoureusement identique, enterrer la diversité au bas du fil rapporte de l'engagement et n'était vu par aucune des mesures retenues jusqu'ici. Une mesure consciente du rang en rend compte ; sans remise, la courbe est plate et l'échappatoire est gratuite.
La divergence à une référence déclarée résout le défaut de principe du notebook 13. Les cinq mesures de RADio sont la même formule appliquée à cinq références, et c'est la référence qui porte la valeur. Une calibration nulle est l'objectif d'un recommandeur libéral et la définition d'une bulle pour un recommandeur délibératif : la mesure oblige à choisir au lieu de choisir en silence.
L'évaluation naïve d'un réordonnancement est fausse de 201 % en médiane, jusqu'à 851 %, et son sens n'est pas garanti. Les estimateurs contrefactuels retrouvent la valeur vraie à moins d'un point — à trois conditions, qui doivent être publiées avec le chiffre : le modèle de propension employé, la taille d'échantillon effective, et le plafond s'il y en a un.
Ce n'est pas un raffinement à apporter après l'évaluation sur données réelles. C'est ce qui décide si cette évaluation mesurera quoi que ce soit.
Les hypothèses qui restent¶
Le modèle de biais de position — l'exposition ne dépend que du rang — est une hypothèse, non une mesure. Sur un jeu de données public, la politique d'enregistrement n'est pas fournie : la plateforme n'a pas publié ses probabilités de service. Tout ce qui précède déplace donc le problème d'un cran, de « les clics sont des étiquettes » vers « l'exposition se modélise par le rang ». Le second énoncé est bien meilleur que le premier, et il reste un énoncé.
Pistes ouvertes¶
- Estimer la sévérité du biais de position plutôt que la poser. Les méthodes d'intervention harvesting et les modèles de position par maximum de vraisemblance l'estiment à partir des données enregistrées elles-mêmes.
- Instancier les cinq références de RADio sur des données réelles. Trois d'entre elles — activation, représentation, voix alternatives — demandent des attributs que ce dépôt n'a pas, et le corpus étendu a montré ce que coûte de prendre une étiquette disponible pour l'attribut qu'on voudrait mesurer.
- Comparer à des lignes de base réglées. Un filtre de diversité doit être opposé à un MMR et à un réordonnancement aléatoire, non au seul filtre d'engagement pur qui est un homme de paille.
- Reprendre le test adverse sous mesure consciente du rang. Les quatre mesures du notebook 13 ont été éprouvées sans rang ; l'enterrement les concerne toutes.
Source exécutable : 14_rang_et_contrefactuel.ipynb