15 — Le test adverse sous mesure consciente du rang, et l'estimation du biais de position
Le notebook 14 a laissé deux dettes explicites.
La première. Les quatre mesures comparées au notebook 13 ont été éprouvées sur des compositions, jamais sur des fils ordonnés. L'enterrement les concerne donc toutes, et aucune n'a été jugée avec lui.
La seconde. Les estimateurs contrefactuels reposent sur un modèle de biais de position dont la sévérité \(\eta\) était posée, non mesurée.
Ce que ce notebook établit :
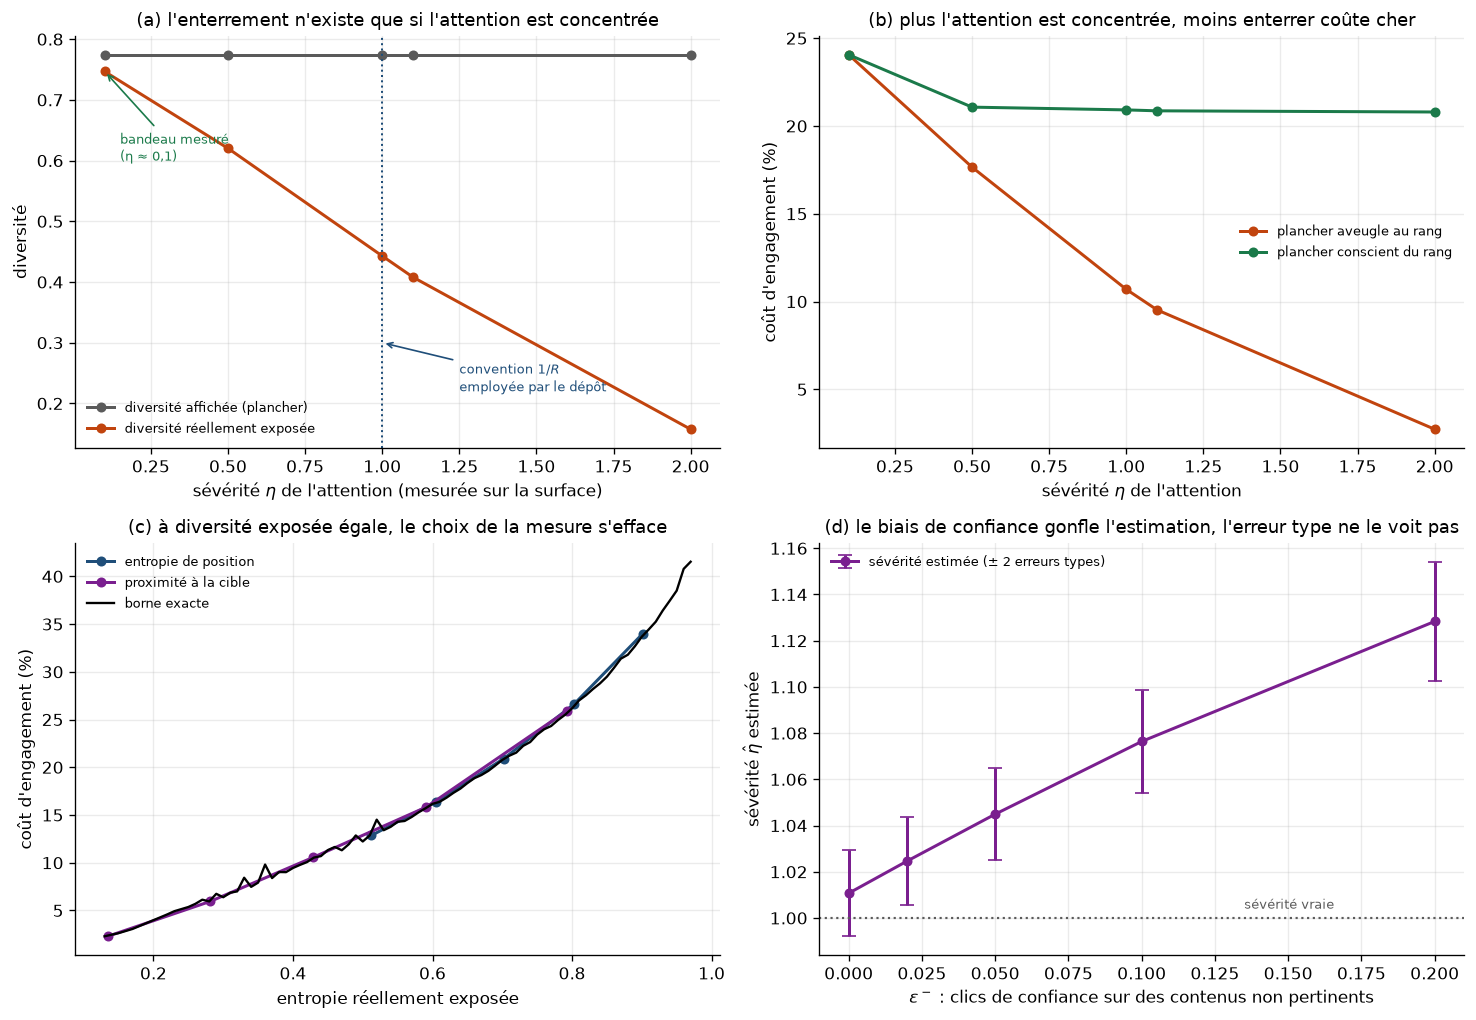
- sous un plancher aveugle au rang, les quatre mesures se laissent contourner par l'enterrement — une plateforme certifiée à 0,70 n'expose que 0,36 ;
- un plancher conscient du rang ferme l'échappatoire, au prix d'un coût d'engagement qui double ;
- \(\eta\) s'estime à partir des seules données enregistrées, à condition que la plateforme ait varié ses classements — et le refus d'estimer, quand elle ne l'a pas fait, est aussi un résultat ;
- poser \(\eta\) de travers coûte jusqu'à 179 % d'erreur, soit l'ordre de grandeur du biais qu'on prétendait corriger. Corriger ne suffit pas : il faut estimer la correction.
1. Les quatre mesures, cette fois sur des fils ordonnés
Le fil compte \(n\) positions à remplir depuis un catalogue de \(k\) points de vue, soit \(k^n\) fils possibles. Ils sont tous énumérés : l'optimum est exact, non le résultat d'une heuristique.
Ce n'est pas un luxe. Il s'agit encore de résultats négatifs — des normes qui échouent — et un optimum manqué par un solveur y produirait exactement la même apparence qu'une norme qui tient.
import numpy as np
import matplotlib.pyplot as plt

from ide.gaming import (
    canonical_positions,
    gaussian_ild,
    position_entropy,
    rao_entropy,
    target_divergence,
)
from ide.offpolicy import (
    estimate_position_bias,
    naive,
    rank_propensities,
    simulate_logged_feedback,
    simulate_ranked_feedback,
    snips,
    value_under_policy,
)
from ide.plotting import PALETTE, save_figure, use_project_style
from ide.ranking import all_rankings, optimal_ranking_under, ranking_engagement

use_project_style()

VIEWPOINTS, SLOTS = 4, 8
CATALOGUE = canonical_positions(VIEWPOINTS)
REFERENCE = float(np.ptp(CATALOGUE))
BANDWIDTH = float(CATALOGUE[1] - CATALOGUE[0])

# Un lecteur qui préfère nettement le premier point de vue : sans cette préférence, il n'y
# aurait aucun intérêt à enterrer quoi que ce soit.
RELEVANCE = np.array([0.90, 0.45, 0.25, 0.15])

MEASURES = {
    "Rao (ILD)": lambda w: rao_entropy(w, CATALOGUE, REFERENCE),
    "entropie de position": lambda w: position_entropy(w, CATALOGUE, CATALOGUE),
    "Gaussian ILD": lambda w: gaussian_ild(w, CATALOGUE, BANDWIDTH),
    "proximité à la cible": lambda w: target_divergence(w, CATALOGUE, CATALOGUE),
}

unconstrained = ranking_engagement(np.zeros(SLOTS, dtype=int), RELEVANCE)
print(f"{VIEWPOINTS ** SLOTS} fils énumérés pour chaque norme")
print(f"engagement sans contrainte : {unconstrained:.3f}")
65536 fils énumérés pour chaque norme
engagement sans contrainte : 2.446
FLOOR = 0.70

print(f"plancher imposé : {FLOOR}\n")
print(f"{'mesure':22s} {'norme':>12s} {'coût':>8s} {'affiché':>9s} {'exposé':>8s}   fil servi")
print("-" * 88)
results = {}
for name, measure in MEASURES.items():
    for aware in (False, True):
        best = optimal_ranking_under(measure, RELEVANCE, SLOTS, FLOOR, rank_aware=aware)
        results[name, aware] = best
        label = "consciente" if aware else "aveugle"
        if best is None:
            print(f"{name:22s} {label:>12s}   plancher inatteignable")
            continue
        cost = 100 * (1 - best.engagement / unconstrained)
        print(f"{name:22s} {label:>12s} {cost:7.1f}% {best.blind:9.3f} {best.aware:8.3f}"
              f"   {''.join(map(str, best.assignment))}")
plancher imposé : 0.7

mesure                        norme     coût   affiché   exposé   fil servi
----------------------------------------------------------------------------------------


Rao (ILD)                   aveugle     8.2%     0.750    0.355   00000033


Rao (ILD)                consciente    18.9%     0.938    0.702   00033300


entropie de position        aveugle    10.7%     0.774    0.443   00000123


entropie de position     consciente    20.9%     0.953    0.702   00013122


Gaussian ILD                aveugle   plancher inatteignable


Gaussian ILD             consciente   plancher inatteignable


proximité à la cible        aveugle     5.9%     0.750    0.628   00000012


proximité à la cible     consciente    10.6%     0.750    0.701   00100200
Lecture
La colonne affiché est ce que la norme constate ; la colonne exposé est la diversité que le lecteur reçoit réellement, une fois l'attention de chaque rang prise en compte.
Sous plancher aveugle, l'écart est béant. L'entropie de Rao certifie un fil à 0,750 dont la diversité exposée vaut 0,355 ; l'entropie de position certifie 0,774 pour 0,443. Le fil optimal est à chaque fois de la même forme — six contenus du point de vue préféré, puis les divergents relégués aux dernières positions.
Une plateforme certifiée à 0,70 n'expose donc que la moitié de ce qu'on lui compte.
Sous plancher conscient du rang, l'échappatoire est fermée : la diversité exposée atteint le plancher, et les contenus divergents remontent dans le fil. Le prix est réel — le coût d'engagement passe de 8,2 % à 18,9 % pour Rao, de 10,7 % à 20,9 % pour l'entropie de position.
La Gaussian ILD reste inatteignable au-delà de 0,5 : sa borne dépend de \(k\) et de la largeur de bande, ce que le notebook 13 avait déjà relevé comme l'empêchant de servir de seuil.
print("Écart entre diversité affichée et diversité exposée, par plancher\n")
print(f"{'plancher':>9s}" + "".join(f"{n[:18]:>20s}" for n in MEASURES))
print("-" * 89)
scan = {}
for floor in (0.4, 0.5, 0.6, 0.7, 0.8):
    row = ""
    for name, measure in MEASURES.items():
        best = optimal_ranking_under(measure, RELEVANCE, SLOTS, floor, rank_aware=False)
        scan[name, floor] = best
        row += f"{'—':>20s}" if best is None else f"{best.blind - best.aware:20.3f}"
    print(f"{floor:9.2f}{row}")

print("\nL'écart n'est pas un artefact d'un plancher particulier : il croît avec l'exigence.")
print("Plus la norme aveugle demande de diversité, plus il devient rentable de l'enterrer.")
Écart entre diversité affichée et diversité exposée, par plancher

 plancher           Rao (ILD)  entropie de positi        Gaussian ILD  proximité à la cib
-----------------------------------------------------------------------------------------


     0.40               0.262               0.173               0.200               0.000


     0.50               0.306               0.249               0.194               0.066


     0.60               0.350               0.263                   —               0.066


     0.70               0.395               0.331                   —               0.122


     0.80               0.397               0.319                   —               0.166

L'écart n'est pas un artefact d'un plancher particulier : il croît avec l'exigence.
Plus la norme aveugle demande de diversité, plus il devient rentable de l'enterrer.
Une mesure se compare à elle-même
Le test adverse avait dû renoncer à seuiller l'écart entre deux indices différents — IDE et Rao ne sont pas sur la même échelle, et un fil honnête en affichait déjà 0,36. L'écart mesuré ici est d'une autre nature : c'est la même mesure appliquée deux fois au même fil, une fois à l'aveugle du rang et une fois en le prenant en compte.
Il vaut zéro pour un fil dont l'ordre ne concentre pas l'attention, et il est directement interprétable — ce qui en fait, cette fois, une grandeur seuillable.
2. Estimer \(\eta\) plutôt que le poser
Le modèle à biais de position pose \(P(\text{clic}) = R^{-\eta}\,g(i)\), donc
La pertinence \(g(i)\) y est un effet fixe de contenu : on ne cherche pas à l'estimer, on l'élimine en centrant à l'intérieur de chaque contenu. Ce qui subsiste est la seule variation qui identifie \(\eta\) — celle d'un même contenu vu à des rangs différents.
C'est la forme la plus simple de la récolte d'interventions : elle n'exige aucune expérience, seulement que la plateforme n'ait pas toujours classé les mêmes contenus aux mêmes places.
rng = np.random.default_rng(5)
catalogue_relevance = rng.uniform(0.15, 0.9, 12)

print(f"{'η vrai':>8s} {'η estimé':>10s} {'erreur type':>12s} {'contenus variables':>19s}")
print("-" * 52)
for true_severity in (0.4, 0.7, 1.0, 1.3, 1.6):
    items, ranks, clicks = simulate_ranked_feedback(
        catalogue_relevance, 40_000, true_severity, exploration=0.5, rng=rng
    )
    estimate = estimate_position_bias(items, ranks, clicks)
    print(f"{true_severity:8.2f} {estimate.severity:10.3f} {estimate.standard_error:12.4f}"
          f" {estimate.items_with_variation:19d}")
  η vrai   η estimé  erreur type  contenus variables
----------------------------------------------------


    0.40      0.409       0.0045                  12


    0.70      0.693       0.0064                  12


    1.00      1.005       0.0085                  12


    1.30      1.315       0.0121                  12


    1.60      1.649       0.0192                  12
print("L'exploration de la plateforme est la condition d'identifiabilité\n")
print(f"{'exploration':>12s} {'η estimé':>10s} {'erreur type':>12s} {'variables':>10s}  identifiable")
print("-" * 66)
identifiability = []
for exploration in (0.0, 0.02, 0.05, 0.15, 0.5, 1.5):
    items, ranks, clicks = simulate_ranked_feedback(
        catalogue_relevance, 40_000, 1.0, exploration=exploration, rng=rng
    )
    estimate = estimate_position_bias(items, ranks, clicks)
    identifiability.append((exploration, estimate))
    severity = f"{estimate.severity:10.3f}" if estimate.identifiable else f"{'n/a':>10s}"
    error = f"{estimate.standard_error:12.4f}" if estimate.identifiable else f"{'n/a':>12s}"
    print(f"{exploration:12.2f} {severity} {error} {estimate.items_with_variation:10d}"
          f"  {'oui' if estimate.identifiable else 'NON'}")

print("\nÀ exploration nulle, aucun contenu ne change de rang : le paramètre n'est pas dans")
print("les données, et la fonction refuse de renvoyer un chiffre plutôt que d'en inventer un.")
print("À exploration faible, elle en renvoie un — mais l'erreur type dit qu'il ne vaut rien.")
L'exploration de la plateforme est la condition d'identifiabilité

 exploration   η estimé  erreur type  variables  identifiable
------------------------------------------------------------------


        0.00        n/a          n/a          0  NON


        0.02      1.595       0.2468         10  oui


        0.05      0.800       0.0923         12  oui


        0.15      1.031       0.0364         12  oui


        0.50      1.004       0.0112         12  oui


        1.50      0.990       0.0083         12  oui

À exploration nulle, aucun contenu ne change de rang : le paramètre n'est pas dans
les données, et la fonction refuse de renvoyer un chiffre plutôt que d'en inventer un.
À exploration faible, elle en renvoie un — mais l'erreur type dit qu'il ne vaut rien.
3. Pourquoi il fallait l'estimer
La question qui relie les deux moitiés de ce notebook : que coûte un \(\eta\) posé de travers ?
ITEMS, IMPRESSIONS, TRUE_SEVERITY = 20, 400_000, 1.0
rng = np.random.default_rng(11)

relevance = rng.uniform(0.05, 0.95, ITEMS)
diversity = rng.uniform(0.0, 1.0, ITEMS)
logged_ranks = np.argsort(np.argsort(-relevance)) + 1
target_ranks = np.argsort(np.argsort(-(0.4 * relevance + 0.6 * diversity))) + 1

logged = rank_propensities(logged_ranks, TRUE_SEVERITY)
target = rank_propensities(target_ranks, TRUE_SEVERITY)
examined, clicks = simulate_logged_feedback(relevance, logged, IMPRESSIONS, rng)
true_cost = 1 - value_under_policy(relevance, target) / value_under_policy(relevance, logged)


def cost_assuming(severity):
    assumed_logged = rank_propensities(logged_ranks, severity)
    assumed_target = rank_propensities(target_ranks, severity)
    return 1 - snips(clicks, assumed_target[examined], assumed_logged[examined]) / naive(clicks)


print(f"coût réel du filtre de diversité : {100 * true_cost:.1f} %\n")
print(f"{'η supposé':>11s} {'coût estimé':>12s} {'erreur':>9s}")
print("-" * 36)
sensitivity = []
for severity in (0.5, 0.8, 1.0, 1.2, 1.5, 2.0):
    estimated = cost_assuming(severity)
    sensitivity.append((severity, estimated))
    print(f"{severity:11.1f} {100 * estimated:11.1f} % {100 * (estimated - true_cost) / true_cost:8.1f} %")
coût réel du filtre de diversité : 6.6 %

  η supposé  coût estimé    erreur
------------------------------------
        0.5         2.7 %    -59.0 %
        0.8         4.9 %    -25.6 %
        1.0         6.6 %      0.6 %
        1.2         8.6 %     30.1 %
        1.5        11.9 %     80.3 %
        2.0        18.4 %    178.8 %
items, ranks, click_flags = simulate_ranked_feedback(
    relevance, 40_000, TRUE_SEVERITY, exploration=0.5, rng=rng
)
measured = estimate_position_bias(items, ranks, click_flags)
low = measured.severity - 2 * measured.standard_error
high = measured.severity + 2 * measured.standard_error
band = [cost_assuming(value) for value in (low, measured.severity, high)]

print(f"η estimé sur les données enregistrées : {measured.severity:.3f}"
      f" ± {2 * measured.standard_error:.3f}\n")
print(f"  coût estimé sur cet intervalle : {100 * min(band):.1f} % à {100 * max(band):.1f} %")
print(f"  coût réel                      : {100 * true_cost:.1f} %")
print("\nL'incertitude sur η devient une bande de quelques dixièmes de point sur le résultat,")
print("là où un η posé au jugé pouvait le tripler.")
η estimé sur les données enregistrées : 1.013 ± 0.019

  coût estimé sur cet intervalle : 6.6 % à 6.9 %
  coût réel                      : 6.6 %

L'incertitude sur η devient une bande de quelques dixièmes de point sur le résultat,
là où un η posé au jugé pouvait le tripler.
figure, axes = plt.subplots(2, 2, figsize=(11.5, 7.8))
exposure, spread, recovery, sensitivity_panel = axes.ravel()

# (a) Affiché contre exposé, sous plancher aveugle puis conscient.
names = [n for n in MEASURES if results[n, False] is not None]
positions = np.arange(len(names))
displayed = [results[n, False].blind for n in names]
received = [results[n, False].aware for n in names]
exposure.bar(positions - 0.19, displayed, 0.36, color=PALETTE["neutral"],
             label="diversité affichée")
exposure.bar(positions + 0.19, received, 0.36, color=PALETTE["disorder"],
             label="diversité réellement exposée")
exposure.axhline(FLOOR, color=PALETTE["order"], linestyle="--", linewidth=1.5)
exposure.text(len(names) - 0.55, FLOOR + 0.02, f"plancher {FLOOR:.2f}", fontsize=8,
              color=PALETTE["order"], ha="right")
exposure.set_xticks(positions)
exposure.set_xticklabels([n.replace(" ", "\n") for n in names], fontsize=7.5)
exposure.set_ylabel("valeur de la mesure")
exposure.set_ylim(0, 1.05)
exposure.set_title("Sous plancher aveugle, l'exposé est bien moindre", fontsize=10)
exposure.legend(fontsize=7.5, loc="upper right")

# (b) L'écart croît avec l'exigence de la norme.
floors = [0.4, 0.5, 0.6, 0.7, 0.8]
palette = [PALETTE["disorder"], PALETTE["remedy"], PALETTE["neutral"], PALETTE["order"]]
for (name, _), colour in zip(MEASURES.items(), palette, strict=True):
    curve = [scan[name, floor].blind - scan[name, floor].aware
             if scan[name, floor] is not None else np.nan for floor in floors]
    spread.plot(floors, curve, marker="o", markersize=4, linewidth=1.7, color=colour, label=name)
spread.set_xlabel("plancher aveugle imposé")
spread.set_ylabel("écart affiché − exposé")
spread.set_title("Plus la norme exige, plus enterrer rapporte", fontsize=10)
spread.legend(fontsize=7.5)

# (c) La sévérité retrouvée, et le seuil d'identifiabilité.
explorations = [value for value, estimate in identifiability if estimate.identifiable]
estimates = [estimate.severity for _, estimate in identifiability if estimate.identifiable]
errors = [2 * estimate.standard_error for _, estimate in identifiability if estimate.identifiable]
recovery.errorbar(explorations, estimates, yerr=errors, marker="o", markersize=5,
                  linewidth=1.6, capsize=3, color=PALETTE["remedy"])
recovery.axhline(1.0, color=PALETTE["order"], linestyle="--", linewidth=1.5)
recovery.text(0.55, 1.02, "η vrai", fontsize=8, color=PALETTE["order"])
recovery.axvline(0.0, color=PALETTE["disorder"], linewidth=2.5)
recovery.text(0.024, 0.66, "plateforme déterministe :\nη non identifiable", fontsize=8,
              color=PALETTE["disorder"], va="bottom")
recovery.set_xscale("symlog", linthresh=0.02)
recovery.set_xlim(-0.004, 2.2)
recovery.set_xlabel("exploration du classement de la plateforme")
recovery.set_ylabel("η estimé")
recovery.set_title("η s'estime, si la plateforme a varié ses rangs", fontsize=10)

# (d) Ce que coûte un η posé au jugé.
assumed = [value for value, _ in sensitivity]
estimated = [100 * value for _, value in sensitivity]
sensitivity_panel.plot(assumed, estimated, marker="o", markersize=5, linewidth=1.8,
                       color=PALETTE["field"], label="coût estimé")
sensitivity_panel.axhline(100 * true_cost, color=PALETTE["order"], linestyle="--", linewidth=1.5)
sensitivity_panel.text(0.52, 100 * true_cost + 0.5, "coût réel", fontsize=8,
                       color=PALETTE["order"])
sensitivity_panel.axvspan(low, high, color=PALETTE["remedy"], alpha=0.25)
sensitivity_panel.text((low + high) / 2, 17.0, "η estimé\n± 2 erreurs types", fontsize=7.5,
                       color=PALETTE["remedy"], ha="center")
sensitivity_panel.set_xlabel("η supposé par l'estimateur")
sensitivity_panel.set_ylabel("coût estimé du filtre  [%]")
sensitivity_panel.set_title("Corriger avec le mauvais η corrige mal", fontsize=10)
sensitivity_panel.legend(fontsize=8, loc="upper left")

figure.suptitle("Rang adverse et sévérité : ce qu'une norme aveugle laisse passer", fontsize=12)
figure.tight_layout(rect=(0, 0, 1, 0.96))
save_figure(figure, "fig15_rang_adverse")
plt.show()
4. Ce que le notebook établit
Les quatre mesures se laissent contourner par l'enterrement. Jugées sur des fils ordonnés plutôt que sur des compositions, toutes certifient une diversité que le lecteur ne reçoit pas. À plancher 0,70, l'entropie de Rao certifie 0,750 pour une diversité exposée de 0,355. Le test adverse initial ne les avait pas éprouvées contre cet adversaire — c'est fait.
Un plancher conscient du rang le ferme, et il coûte. Le prix d'engagement double : de 8,2 % à 18,9 % pour l'entropie de Rao, de 10,7 % à 20,9 % pour l'entropie de position. Une norme qui ne coûterait pas davantage ne fermerait rien.
L'écart affiché − exposé est cette fois seuillable. Contrairement à l'écart entre deux indices différents, que le test adverse avait dû renoncer à seuiller, celui-ci compare la même mesure à elle-même. Il vaut zéro pour un fil qui ne relègue pas, et croît avec l'exigence de la norme aveugle — plus elle demande, plus enterrer rapporte.
La sévérité du biais de position s'estime, à ±0,02 sur 40 000 impressions, par une régression à effets fixes de contenu. Mais seulement si la plateforme a varié ses classements : à politique déterministe, le paramètre n'est pas dans les données et l'estimateur refuse de renvoyer un chiffre.
Et il fallait l'estimer. Poser \(\eta = 0{,}5\) au lieu de 1,0 donne une erreur de −59 % ; poser 2,0 donne +179 %. C'est l'ordre de grandeur du biais qu'on prétendait corriger.
Corriger ne suffit pas : il faut estimer le paramètre de la correction, et publier son incertitude. Sur l'intervalle estimé, le coût tient entre 6,6 % et 6,9 % — contre une fourchette de 2,7 % à 18,4 % si l'on pose \(\eta\) au jugé.
Les hypothèses qui restent
La forme \(e(R) = R^{-\eta}\) est posée, et seule sa sévérité est estimée. Un modèle d'examen plus riche — dépendant du contenu, ou de ce que le lecteur a déjà vu — donnerait des propensions différentes.
L'énumération exhaustive borne par ailleurs la taille des fils étudiés : huit positions sur quatre points de vue. Rien n'assure que le comportement observé se transporte à un fil de cinquante items sur cinquante points de vue, et l'affirmer demanderait une optimisation dont l'exactitude ne serait plus garantie.
Pistes ouvertes
- Vérifier que l'enterrement se transporte à grande échelle. L'énumération exhaustive s'arrête à quelques dizaines de milliers de fils ; au-delà, il faudrait une optimisation approchée, dont il faudrait alors établir qu'elle n'invente pas le résultat.
- Enrichir le modèle d'examen. La sévérité est estimée sous l'hypothèse que l'attention ne dépend que du rang. Les modèles à confiance ou à cascade la font dépendre aussi de ce que le lecteur a déjà consulté.
- Mesurer l'exploration réelle d'un jeu de données public avant d'en tirer quoi que ce soit : c'est elle qui décide si \(\eta\) y est identifiable, et donc si l'évaluation contrefactuelle y est possible.
- Comparer à des lignes de base réglées — MMR, réordonnancement aléatoire, popularité — qui reste la dette du programme d'évaluation.
Source exécutable : 15_rang_adverse_et_severite.ipynb