16 — L'exploration réellement enregistrée dans MIND
Le notebook 15 a montré comment estimer la sévérité \(\eta\) du biais de position au lieu de la poser, et ce que coûte de la poser de travers : jusqu'à +179 % sur le chiffre publié. Il a aussi montré à quelle condition cette estimation existe — que la plateforme n'ait pas toujours classé les mêmes contenus aux mêmes places.
Cette condition est une propriété du jeu de données, pas de la méthode. D'où le préalable inscrit à la feuille de route : mesurer l'exploration réelle avant d'évaluer quoi que ce soit. Ce notebook la mesure sur MIND (Microsoft News Dataset, Wu et al., ACL 2020), le jeu de référence de la recommandation d'actualité, celui sur lequel l'évaluation de l'ADE était prévue.
Ce que ce notebook établit :
- l'ordre enregistré dans MIND est indiscernable d'un mélange — \(z = +0{,}12\), \(p = 0{,}91\), répliqué sur le second découpage — dans un jeu où le test détecterait \(\eta = 0{,}02\) à douze écarts-types ;
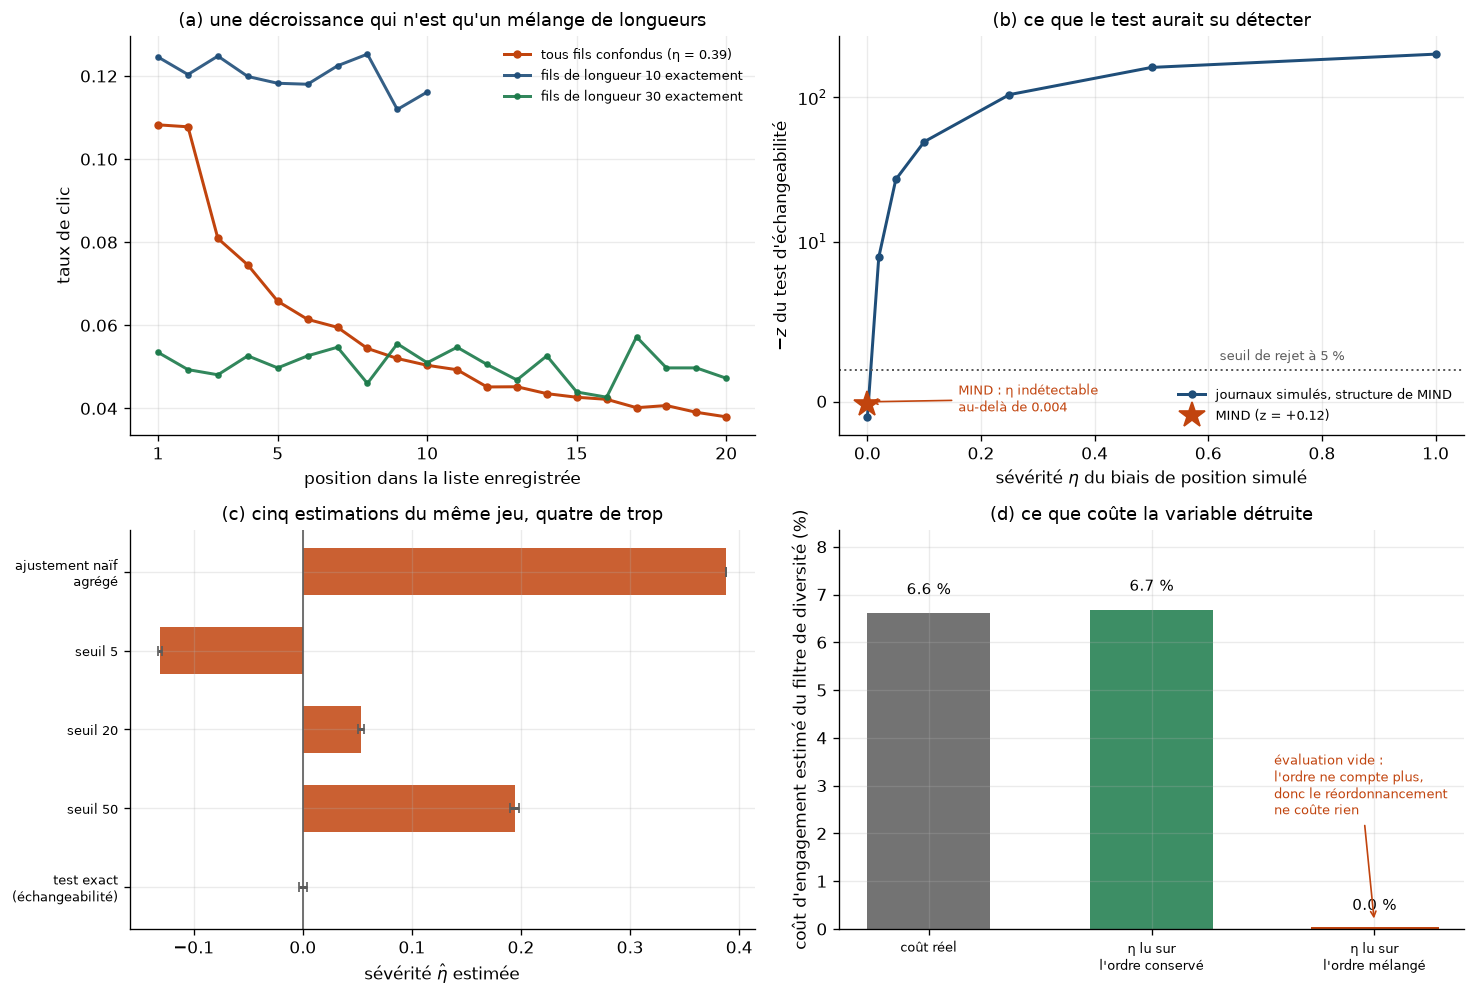
- la courbe la plus naturelle à tracer, le taux de clic par position, y décroît pourtant de 0,108 à 0,038 et donne \(\hat\eta = 0{,}39\) : un artefact de composition, les positions élevées n'existant que dans les fils longs ;
estimate_position_biasaccepte ce jeu sans broncher et renvoie trois sévérités incompatibles selon un seuil de nuisance, dont une négative, toutes assorties d'une erreur type inférieure à 0,005 — le contrôle d'identifiabilité du notebook 15 est donc nécessaire et non suffisant ;- le mélange ne débiaise pas les clics : il détruit la variable qui permettrait de les corriger, et ramène l'analyste à l'estimation naïve dont le notebook 14 a mesuré l'erreur.
Le jeu brut n'est pas versionné — licence de recherche Microsoft, 135 Mo. Ce notebook lit le
condensé data/mind_digest.npz, qui rend à l'identique tous les chiffres ci-dessous et se
reconstruit par scripts/fetch_mind.py puis scripts/build_mind_digest.py.
import numpy as np
import matplotlib.pyplot as plt

from ide.mind import (
    click_rate_by_rank,
    detectable_severity,
    exchangeability_test,
    load_digest,
    naive_severity_fit,
    simulate_feeds,
)
from ide.offpolicy import (
    estimate_position_bias,
    naive,
    rank_propensities,
    simulate_logged_feedback,
    simulate_ranked_feedback,
    snips,
    value_under_policy,
)
from ide.plotting import PALETTE, save_figure, use_project_style

use_project_style()

digest = load_digest()
train = digest.impressions("train")
dev = digest.impressions("dev")

for split, impressions in (("train", train), ("dev", dev)):
    lengths = impressions.feed_lengths
    print(f"{split:6s} {impressions.feed_count:7d} fils  {impressions.served:9d} contenus servis"
          f"  taux de clic {impressions.click_rate:.4f}")
    print(f"       longueur de fil : médiane {np.median(lengths):.0f}, moyenne "
          f"{lengths.mean():.1f}, maximum {lengths.max()}")
print(f"\nsource (SHA-256) : {digest.sources['train']}")
train   156965 fils    5843444 contenus servis  taux de clic 0.0404
       longueur de fil : médiane 24, moyenne 37.2, maximum 299
dev      73152 fils    2740998 contenus servis  taux de clic 0.0406
       longueur de fil : médiane 23, moyenne 37.5, maximum 295

source (SHA-256) : a424547c8fa17c9ea4879c2110221c2b2f2709f4f7615ede0b0d8e4765158658
1. La condition d'identifiabilité est satisfaite — abondamment
Le notebook 15 avait posé le contrôle à faire avant d'estimer \(\eta\) : combien de contenus ont été servis à plusieurs rangs distincts ? C'est la seule variation qui identifie la sévérité, et une plateforme parfaitement déterministe n'en produit aucune.
Sur MIND, la réponse est sans ambiguïté.
items, ranks, clicks = digest.rows("train")
coverage = digest.coverage("train")
print(f"contenus distincts                       : {coverage.items}")
print(f"contenus au-dessus du seuil d'impressions: {coverage.items_above_threshold}")
print(f"contenus vus à plusieurs rangs           : {coverage.items_with_variation}")
print(f"rangs distincts par contenu (médiane)    : {coverage.median_distinct_ranks:.0f}")
print(f"rang maximal observé                     : {coverage.maximum_rank}")
print("\nUn contenu médian retenu a été servi à seize positions différentes.")
print("À ce compte, l'exploration paraît idéale — c'est ce que ce notebook va défaire.")
contenus distincts                       : 20288
contenus au-dessus du seuil d'impressions: 2950
contenus vus à plusieurs rangs           : 2655
rangs distincts par contenu (médiane)    : 16
rang maximal observé                     : 299

Un contenu médian retenu a été servi à seize positions différentes.
À ce compte, l'exploration paraît idéale — c'est ce que ce notebook va défaire.
2. La courbe qu'on trace naturellement
Taux de clic par position, tous fils confondus. C'est le premier graphique que produit quiconque cherche un biais de position, et il a exactement l'allure attendue.
aggregate = click_rate_by_rank(train, maximum_rank=20)
severity_aggregate = naive_severity_fit(train, maximum_rank=20)

print(f"{'rang':>5s} {'taux de clic':>13s}")
print("-" * 20)
for position in (1, 2, 3, 5, 10, 15, 20):
    print(f"{position:5d} {aggregate[position - 1]:13.5f}")
print(f"\najustement log-log sur les rangs 1-20 : η = {severity_aggregate:.3f}")
print("Une décroissance de 0,108 à 0,038, régulière, sur 5,8 millions de contenus servis.")
 rang  taux de clic
--------------------
    1       0.10825
    2       0.10778
    3       0.08091
    5       0.06580
   10       0.05038
   15       0.04269
   20       0.03797

ajustement log-log sur les rangs 1-20 : η = 0.388
Une décroissance de 0,108 à 0,038, régulière, sur 5,8 millions de contenus servis.
Ce que cette courbe mesure en réalité
Les fils de MIND n'ont pas tous la même longueur : la médiane est de 24 contenus, la moyenne de 37, le maximum de 299. Or la position 20 n'existe que dans les fils d'au moins 20 contenus, et le taux de clic par contenu servi y est mécaniquement plus faible — un lecteur qui clique une fois dans un fil de 100 contenus produit un taux de 0,01, le même clic dans un fil de 4 contenus en produit 0,25.
La courbe agrégée mélange donc deux choses : l'effet du rang, et la composition du mélange de longueurs. Il suffit de tenir la longueur fixée pour les séparer.
print(f"{'longueur':>9s} {'fils':>7s}   taux de clic aux positions 1 à 10")
print("-" * 78)
fixed = {}
for length in (6, 10, 15, 20, 30, 50):
    count = int((train.feed_lengths == length).sum())
    rates = click_rate_by_rank(train, maximum_rank=min(length, 10), feed_length=length)
    fixed[length] = click_rate_by_rank(train, maximum_rank=length, feed_length=length)
    row = " ".join(f"{value:.3f}" for value in rates)
    print(f"{length:9d} {count:7d}   {row}")

print(f"\n{'longueur':>9s} {'η apparent':>11s}")
print("-" * 22)
for length in (6, 10, 15, 20, 30, 50):
    print(f"{length:9d} {naive_severity_fit(train, maximum_rank=length, feed_length=length):11.3f}")
print("\nÀ longueur fixée, la courbe est plate — et sa pente change de signe d'une longueur à")
print("l'autre. Les 0,39 de la courbe agrégée ne mesuraient que le mélange des longueurs.")
 longueur    fils   taux de clic aux positions 1 à 10
------------------------------------------------------------------------------
        6    3053   0.173 0.179 0.180 0.175 0.179 0.184
       10    4279   0.125 0.120 0.125 0.120 0.118 0.118 0.122 0.125 0.112 0.116


       15    2184   0.079 0.082 0.073 0.077 0.085 0.083 0.082 0.080 0.089 0.073
       20    2187   0.055 0.069 0.069 0.060 0.059 0.067 0.070 0.062 0.064 0.068
       30    2412   0.053 0.049 0.048 0.053 0.050 0.053 0.055 0.046 0.056 0.051
       50    1108   0.034 0.039 0.044 0.038 0.041 0.043 0.026 0.042 0.039 0.041

 longueur  η apparent
----------------------
        6      -0.022
       10       0.025
       15      -0.025
       20      -0.033
       30      -0.002
       50       0.037

À longueur fixée, la courbe est plate — et sa pente change de signe d'une longueur à
l'autre. Les 0,39 de la courbe agrégée ne mesuraient que le mélange des longueurs.
3. Le test d'échangeabilité
Le contrôle par longueur fixée est parlant mais partiel : il jette la plupart des fils, et laisse encore jouer la qualité moyenne des contenus d'un fil ou l'appétit de clic de son lecteur.
Le test exact conditionne au fil. Pour un fil de longueur \(L\) portant \(k\) clics, on somme les rangs normalisés \(u_R = (R - 1/2)/L\) des contenus cliqués. Sous l'hypothèse que les clics sont indifférents à la position, ces \(k\) positions sont un tirage sans remise parmi les \(L\) positions du fil, d'espérance et de variance connues exactement :
Un biais de position concentre les clics en haut : il rend l'écart réduit négatif.
print(f"{'découpage':>10s} {'fils utiles':>12s} {'somme observée':>15s} {'attendue':>12s}"
      f" {'z':>8s} {'p':>7s}")
print("-" * 70)
verdicts = {}
for split, impressions in (("train", train), ("dev", dev)):
    verdict = exchangeability_test(impressions)
    verdicts[split] = verdict
    print(f"{split:>10s} {verdict.feeds_used:12d} {verdict.statistic:15.1f}"
          f" {verdict.expectation:12.1f} {verdict.deviation:8.3f} {verdict.p_value:7.3f}")

print("\nLes clics tombent exactement là où le hasard les mettrait, sur les deux découpages.")
 découpage  fils utiles  somme observée     attendue        z       p
----------------------------------------------------------------------


     train       156965        118187.9     118172.0    0.116   0.908


       dev        73152         55717.7      55691.5    0.278   0.781

Les clics tombent exactement là où le hasard les mettrait, sur les deux découpages.
Un test qui ne rejette rien ne dit rien — tant qu'on ignore ce qu'il rejetterait
C'est l'étalonnage indispensable d'un résultat négatif. On simule des journaux de même structure de fils que MIND — mêmes longueurs, même distribution — sous un biais de position de sévérité connue, et on relève ce que le test en dit.
generator = np.random.default_rng(16)
print(f"{'η simulé':>9s} {'z':>10s} {'η naïf agrégé':>15s}")
print("-" * 37)
power = []
for severity in (0.0, 0.02, 0.05, 0.10, 0.25, 0.50, 1.00):
    simulated = simulate_feeds(train.feed_lengths, severity=severity, rng=generator)
    deviation = exchangeability_test(simulated).deviation
    power.append((severity, deviation))
    print(f"{severity:9.2f} {deviation:10.2f} {naive_severity_fit(simulated, 20):15.3f}")

threshold = detectable_severity(train.feed_lengths, probe=0.02, rng=np.random.default_rng(17))
print(f"\nécart réduit observé sur MIND : {verdicts['train'].deviation:+.3f}")
print(f"sévérité minimale détectable  : η ≈ {threshold:.4f}")
print("\nLe test voit η = 0,02 à douze écarts-types. Sur MIND il ne voit rien : l'ordre")
print("enregistré ne porte aucune information de placement au-delà de η ≈ 0,005.")
 η simulé          z   η naïf agrégé
-------------------------------------


     0.00       0.94          -0.003


     0.02      -9.02           0.017


     0.05     -26.95           0.049


     0.10     -49.22           0.101


     0.25    -104.44           0.245


     0.50    -161.23           0.510


     1.00    -199.34           1.018


écart réduit observé sur MIND : +0.116
sévérité minimale détectable  : η ≈ 0.0038

Le test voit η = 0,02 à douze écarts-types. Sur MIND il ne voit rien : l'ordre
enregistré ne porte aucune information de placement au-delà de η ≈ 0,005.
La documentation de MIND le disait, en une ligne : « the orders of news in a impressions have been shuffled ». Une ligne de documentation ne dit toutefois ni ce qu'il en reste, ni ce que la mesure donne quand on l'ignore. Les deux se mesurent — et la suite montre que les ignorer ne produit pas une erreur visible, mais un chiffre confiant.
4. Ce que l'estimateur du notebook 15 fait de ce jeu
estimate_position_bias vérifie l'identifiabilité avant de répondre : il refuse d'estimer quand
aucun contenu n'a changé de rang. Sur MIND, des milliers de contenus ont changé de rang. Il
répond donc — et le seuil d'impressions, simple paramètre de nuisance, décide de la réponse.
print(f"{'seuil':>6s} {'η estimé':>10s} {'erreur type':>12s} {'contenus':>9s}  identifiable")
print("-" * 56)
estimates = {}
for minimum in (5, 10, 20, 50, 100):
    estimate = estimate_position_bias(items, ranks, clicks, minimum_impressions=minimum)
    estimates[minimum] = estimate
    print(f"{minimum:6d} {estimate.severity:10.4f} {estimate.standard_error:12.4f}"
          f" {estimate.items_with_variation:9d}  {'oui' if estimate.identifiable else 'NON'}")

print("\nLa sévérité estimée est une fonction croissante du seuil — un simple paramètre de")
print("nuisance — et parcourt −0,13 à +0,25 sans jamais cesser d'être « significative ».")
print("Une sévérité négative voudrait dire que les positions basses reçoivent plus de clics.")
 seuil   η estimé  erreur type  contenus  identifiable
--------------------------------------------------------


     5    -0.1307       0.0020      2655  oui


    10    -0.0465       0.0022      2050  oui


    20     0.0533       0.0027      1429  oui


    50     0.1941       0.0043       705  oui


   100     0.2546       0.0065       369  oui

La sévérité estimée est une fonction croissante du seuil — un simple paramètre de
nuisance — et parcourt −0,13 à +0,25 sans jamais cesser d'être « significative ».
Une sévérité négative voudrait dire que les positions basses reçoivent plus de clics.
Correction du notebook 15
Le contrôle d'identifiabilité y était présenté comme la garde à passer avant d'estimer \(\eta\). Il est nécessaire et non suffisant : il compte la variation de rang sans dire d'où elle vient, et une variation artificielle la satisfait mieux que n'importe quelle exploration réelle. Le test d'échangeabilité est le contrôle manquant, et il doit précéder l'estimation, non la suivre.
5. Le mélange ne débiaise pas les clics
Une lecture répandue veut que mélanger l'ordre enregistré protège du biais de position. Elle confond deux choses.
Les clics de MIND ont été produits par des lecteurs qui voyaient un fil ordonné — l'ordre réel de Microsoft News, celui que le jeu n'a pas conservé. Ils portent donc le biais de position en entier. Ce que le mélange a retiré, c'est le rang, seul régresseur qui aurait permis d'en tenir compte.
L'expérience ci-dessous le montre sur un journal simulé dont on connaît la vérité : on l'estime une fois tel quel, une fois après avoir mélangé l'ordre à l'intérieur de chaque fil.
TRUE_SEVERITY = 1.0
rng = np.random.default_rng(23)
catalogue = rng.uniform(0.15, 0.9, 12)
logged_items, logged_ranks_raw, logged_clicks = simulate_ranked_feedback(
    catalogue, 40_000, TRUE_SEVERITY, exploration=0.5, rng=rng
)

intact = estimate_position_bias(logged_items, logged_ranks_raw, logged_clicks)

# Le mélange de MIND : à l'intérieur de chaque fil, les rangs sont redistribués au hasard.
per_feed = logged_ranks_raw.reshape(-1, catalogue.size)
shuffled_ranks = rng.permuted(per_feed, axis=1).ravel()
erased = estimate_position_bias(logged_items, shuffled_ranks, logged_clicks)

print(f"sévérité vraie du journal simulé   : {TRUE_SEVERITY:.3f}")
print(f"estimée sur l'ordre conservé       : {intact.severity:.3f} ± {intact.standard_error:.3f}")
print(f"estimée après mélange de l'ordre   : {erased.severity:.3f} ± {erased.standard_error:.3f}"
      f"  (identifiable={erased.identifiable})")
print("\nLes clics sont les mêmes dans les deux colonnes : le biais de position n'a pas bougé.")
print("Seule la variable qui permettait de le corriger a disparu.")
sévérité vraie du journal simulé   : 1.000
estimée sur l'ordre conservé       : 1.003 ± 0.008
estimée après mélange de l'ordre   : -0.003 ± 0.006  (identifiable=True)

Les clics sont les mêmes dans les deux colonnes : le biais de position n'a pas bougé.
Seule la variable qui permettait de le corriger a disparu.
Ce que cette perte coûte à l'évaluation
Le notebook 15 a chiffré ce que coûte un \(\eta\) posé de travers. Un journal mélangé conduit l'analyste à \(\hat\eta \approx 0\) — c'est-à-dire à supposer qu'aucune position n'est plus vue qu'une autre, donc à ne rien corriger du tout.
ITEMS, IMPRESSIONS = 20, 400_000
rng = np.random.default_rng(11)

relevance = rng.uniform(0.05, 0.95, ITEMS)
diversity = rng.uniform(0.0, 1.0, ITEMS)
platform_ranks = np.argsort(np.argsort(-relevance)) + 1
target_ranks = np.argsort(np.argsort(-(0.4 * relevance + 0.6 * diversity))) + 1

logged = rank_propensities(platform_ranks, TRUE_SEVERITY)
target = rank_propensities(target_ranks, TRUE_SEVERITY)
examined, clicks_logged = simulate_logged_feedback(relevance, logged, IMPRESSIONS, rng)
true_cost = 1 - value_under_policy(relevance, target) / value_under_policy(relevance, logged)


def cost_assuming(severity):
    assumed_logged = rank_propensities(platform_ranks, severity)
    assumed_target = rank_propensities(target_ranks, severity)
    return 1 - snips(clicks_logged, assumed_target[examined],
                     assumed_logged[examined]) / naive(clicks_logged)


print(f"coût réel du filtre de diversité              : {100 * true_cost:6.2f} %")
print(f"estimé avec η lu sur l'ordre conservé ({intact.severity:.2f}) : "
      f"{100 * cost_assuming(intact.severity):6.2f} %")
print(f"estimé avec η lu sur l'ordre mélangé ({erased.severity:+.2f}) : "
      f"{100 * cost_assuming(max(erased.severity, 0.0)):6.2f} %")
print(f"\nerreur relative après mélange : "
      f"{100 * (cost_assuming(max(erased.severity, 0.0)) / true_cost - 1):+.0f} %")
print("\nLe zéro n'est pas une coïncidence numérique. Sous η = 0, toutes les positions sont")
print("réputées également vues : deux politiques qui ne diffèrent que par l'ordre reçoivent")
print("alors la même valeur estimée, quoi qu'elles fassent. L'évaluation ne se trompe pas")
print("de peu — dans ce cadre, elle est vide par construction.")
coût réel du filtre de diversité              :   6.61 %
estimé avec η lu sur l'ordre conservé (1.00) :   6.68 %
estimé avec η lu sur l'ordre mélangé (-0.00) :   0.00 %

erreur relative après mélange : -100 %

Le zéro n'est pas une coïncidence numérique. Sous η = 0, toutes les positions sont
réputées également vues : deux politiques qui ne diffèrent que par l'ordre reçoivent
alors la même valeur estimée, quoi qu'elles fassent. L'évaluation ne se trompe pas
de peu — dans ce cadre, elle est vide par construction.
6. La figure
figure, axes = plt.subplots(2, 2, figsize=(12.4, 8.4))

# (a) la courbe agrégée et son démenti à longueur fixée
ax = axes[0, 0]
positions = np.arange(1, 21)
ax.plot(positions, aggregate, "o-", color=PALETTE["disorder"], markersize=4,
        label=f"tous fils confondus (η = {severity_aggregate:.2f})")
for length, colour in ((10, PALETTE["order"]), (30, PALETTE["remedy"])):
    rates = fixed[length][:20]
    ax.plot(np.arange(1, rates.size + 1), rates, "o-", color=colour, markersize=3,
            alpha=0.9, label=f"fils de longueur {length} exactement")
ax.set_xlabel("position dans la liste enregistrée")
ax.set_ylabel("taux de clic")
ax.set_title("(a) une décroissance qui n'est qu'un mélange de longueurs")
ax.set_xticks([1, 5, 10, 15, 20])
ax.legend(loc="upper right", fontsize=8)

# (b) puissance du test
ax = axes[0, 1]
severities = np.array([value for value, _ in power])
deviations = np.array([value for _, value in power])
ax.plot(severities, -deviations, "o-", color=PALETTE["order"], markersize=4,
        label="journaux simulés, structure de MIND")
ax.axhline(1.96, color=PALETTE["neutral"], linestyle=":", linewidth=1.2)
ax.text(0.62, 2.6, "seuil de rejet à 5 %", fontsize=8, color=PALETTE["neutral"])
ax.plot([0.0], [-verdicts["train"].deviation], "*", color=PALETTE["disorder"], markersize=16,
        zorder=5, label=f"MIND (z = {verdicts['train'].deviation:+.2f})")
ax.annotate(f"MIND : η indétectable\nau-delà de {threshold:.3f}", xy=(0.0, 0.0),
            xytext=(0.16, -0.6), fontsize=8, color=PALETTE["disorder"],
            arrowprops={"arrowstyle": "->", "color": PALETTE["disorder"], "linewidth": 1.0})
ax.set_yscale("symlog", linthresh=10)
ax.set_xlabel("sévérité $\\eta$ du biais de position simulé")
ax.set_ylabel("$-z$ du test d'échangeabilité")
ax.set_title("(b) ce que le test aurait su détecter")
ax.legend(loc="lower right", fontsize=8)

# (c) les cinq chiffres tirés du même jeu
ax = axes[1, 0]
labels = ["ajustement naïf\nagrégé", "seuil 5", "seuil 20", "seuil 50",
          "test exact\n(échangeabilité)"]
values = [severity_aggregate, estimates[5].severity, estimates[20].severity,
          estimates[50].severity, 0.0]
errors = [0.0, estimates[5].standard_error, estimates[20].standard_error,
          estimates[50].standard_error, threshold]
colours = [PALETTE["disorder"]] * 4 + [PALETTE["remedy"]]
ax.barh(np.arange(5), values, xerr=errors, color=colours, alpha=0.85, height=0.6,
        error_kw={"ecolor": PALETTE["neutral"], "capsize": 3})
ax.axvline(0.0, color=PALETTE["neutral"], linewidth=1.0)
ax.set_yticks(np.arange(5))
ax.set_yticklabels(labels, fontsize=8)
ax.invert_yaxis()
ax.set_xlabel("sévérité $\\hat\\eta$ estimée")
ax.set_title("(c) cinq estimations du même jeu, quatre de trop")

# (d) le rang effacé
ax = axes[1, 1]
names = ["coût réel", "η lu sur\nl'ordre conservé", "η lu sur\nl'ordre mélangé"]
costs = [100 * true_cost, 100 * cost_assuming(intact.severity),
         100 * cost_assuming(max(erased.severity, 0.0))]
ax.bar(names, costs, color=[PALETTE["neutral"], PALETTE["remedy"], PALETTE["disorder"]],
       alpha=0.85, width=0.55)
for index, value in enumerate(costs):
    ax.text(index, value + 0.4, f"{value:.1f} %", ha="center", fontsize=9)
ax.plot([2 - 0.275, 2 + 0.275], [0, 0], color=PALETTE["disorder"], linewidth=3)
ax.annotate("évaluation vide :\nl'ordre ne compte plus,\ndonc le réordonnancement\nne coûte rien",
            xy=(2, 0.15), xytext=(1.55, 2.4), fontsize=8, color=PALETTE["disorder"],
            arrowprops={"arrowstyle": "->", "color": PALETTE["disorder"], "linewidth": 1.0})
ax.set_ylabel("coût d'engagement estimé du filtre de diversité (%)")
ax.set_title("(d) ce que coûte la variable détruite")
ax.set_ylim(0, max(costs) * 1.25)
ax.tick_params(axis="x", labelsize=8)

save_figure(figure, "fig16_exploration_mind")
plt.show()
7. Ce que cette mesure décide
MIND ne peut pas calibrer \(\eta\). Ce n'est pas un défaut de la méthode ni un manque de données — 5,8 millions de contenus servis, 156 965 fils — mais l'absence de la seule variable qui identifierait la sévérité. Aucun raffinement de l'estimateur n'y changera rien.
Trois conséquences, par ordre de portée.
Pour ce dépôt. L'évaluation de l'ADE sur MIND reste possible pour tout ce qui ne dépend pas de l'exposition — composition des fils, diversité servie, coût en pertinence déclarée. Elle est impossible pour ce qui en dépend, c'est-à-dire l'estimation contrefactuelle du coût d'engagement, qui était l'objet même de l'exercice. Il faut soit un jeu qui enregistre le rang d'affichage, soit assumer un \(\eta\) importé — et le notebook 15 a chiffré ce que cela coûte.
Pour quiconque évalue un réordonnancement sur données publiques. Le contrôle à faire n'est pas « ai-je assez de variation de rang ? » mais « cette variation vient-elle de la plateforme ou de l'anonymisation ? ». Les deux se ressemblent parfaitement du point de vue de l'estimateur, et seule la seconde produit des chiffres confiants et faux.
Pour ceux qui publient des journaux. Mélanger l'ordre d'affichage ne rend pas un jeu de données non biaisé : il le rend non corrigible. Publier le rang servi, ou à défaut la propension d'exposition, coûte une colonne et décide de ce qui reste mesurable.
Source exécutable : 16_exploration_mind.ipynb